
Mikse stemmen er sannsynligvis en av de mest kompliserte aspektene ved lydmikking.
Enkelt og greit fordi vi er mye mer følsomme for realismen til en stemme i en innspilling enn for realismen til en elektrisk gitar eller et trommesett.

Da jeg begynte å mikse mine egne låter, hadde jeg mye problemer med å forstå hva jeg skulle gjøre og hvorfor. Hvilken behandling skulle jeg legge til, hvilken innstilling skulle jeg bruke på dette eller hint effekt.
Jeg la til plugins etter råd jeg hadde lest eller hørt, men uten å forstå hvilken innvirkning det hadde på miksen.
Alt dette virket ganske mystisk, faktisk, …
… fordi jeg ikke mestret de essensielle trinnene for å mikse en stemme.
Fordi det faktisk ikke finnes noen regler for å lykkes med vokalmikking, er det likevel et visst antall standardtrinn som er nesten uunngåelige. Og dette, uansett om du mikser på FL Studio, Cubase eller noe annet DAW.
Her er derfor, gjennom denne artikkelen, en detaljert og “trinn-for-trinn” oversikt over hva du må gjøre når du begynner å mikse en lead vokalspor.
Trinn 1: Definer et mål
Den største feilen du kan gjøre når det gjelder vokalmikking, er å begynne uten å ha definert en mållyd.
Jeg vil til og med si, det er å gå og bruke råd du har hørt her og der, på internett eller ikke, uten å ha tenkt over deres relevans i din miks.
“Komprimer med et forhold på 6:1 og en angrepstid på 15 ms.”
“Legg til en equalizer og kutt med -5 dB med et klokke-filter ved 1200 Hz”
…alle disse rådene bør tas med en klype salt fordi:
- de er bare anvendelige for låten / miksen til personen som gir dem, siden de avhenger 100% av det registrerte lydsignalet;
- de vil nødvendigvis variere avhengig av musikksjanger: man komprimerer absolutt ikke en stemme på samme måte for jazz, pop eller hard rock.
Det er grunnen til at du nesten ikke vil finne noen tall, ingen “innstillinger for å mikse stemmen godt” på Projet Home Studio, men bare retningslinjer.
Men hvordan skal man gjøre det?
Vel, det første du må gjøre før du mikser en vokalspor, er å stille spørsmålet om hvilken lyd du ønsker.
Ser du etter en aggressiv, direkte lyd?
Eller kanskje noe mykt og luftig, med mye dynamiske variasjoner?
Vil låten din passe bedre med en veldig tørr stemme eller tvert imot noe med mye romklang?
Ta deg tid til å tenke over denne typen spørsmål for å definere din mållyd — om nødvendig, finn et referansestykke som ligner på det du ønsker å gjøre.
Dette vil gjøre det mulig for deg å mikse stemmen din med et klart mål, som vil samsvare med din låt.
Trinn 2: Forbered vokalsporet før miksing
Generelt, når man tenker på miksing av lead vokaler, tenker man umiddelbart på pluginene man skal legge til.
Det er normalt: det er den morsomste delen av miksingen.
Likevel, før du begynner å legge til effekter av noe slag, er det virkelig viktig å forberede vokalsporet ditt skikkelig.
Hvis vi tar utgangspunkt i at innspillingen er av god kvalitet, vil denne “forberedelsen” oversettes til to hovedhandlinger: comping og redigering.
Comping
Generelt, for en og samme sanglinje, vil du gjøre flere opptak.
På 60-tallet ble mange låter laget i “one take” (én opptak), spesielt fordi innspillingene ble gjort på bånd.
I dag gjør teknologien og lagringskapasiteten til PC-ene våre det enkelt å ta tre eller fire opptak for en og samme låt.
Umiddelbar konsekvens: for en gitt sanglinje kan du velge de beste delene og kombinere dem.
For eksempel, hvis den 1ste setningen er bedre på opptak A enn på opptak B, vil du beholde opptak A. Og slik fortsetter du for hver setning, hvert vers… til du får et komplett og perfekt spor!
Kanskje har du inntrykk av at dette er litt juks. Jeg kan berolige deg: denne teknikken, som kalles comping, brukes av de fleste profesjonelle studioer.
Unntatt i tilfelle av sangen My Heart Will Go On, men ikke alle er Céline Dion! 😉
Ta deg derfor tid til å gjøre flere opptak og kompilere dem til én enkelt spor.
Tips: for å hjelpe deg med å velge delene av stykket ditt, kan du bruke et comp sheet som dette ved å notere de beste delene:

Redigering
Selv på veldig gode opptak, er det alltid ting man ikke ønsker å beholde, som pustelyder eller at hodetelefonene gnisser mot mikrofonen under rolige partier.
I en hjemme-studio kontekst, avhengig av forholdene du spiller inn under, kan det være mye verre:
- støy fra datamaskinen;
- støy fra klimaanlegget;
- en fugl eller en bil utenfor;
- …
Når sangeren synger, er denne typen støy vanligvis dekket, så det er ikke så mye problem (men husk å slå av klimaanlegget når du spiller inn…).
Derimot, på de rolige partiene mellom setninger eller vers, må disse anomaliene absolutt fjernes, ellers vil de komme enda mer frem under miksingen på grunn av kompresjonen.

For å gjøre dette, trenger du bare:
- å klippe ut delene du ikke ønsker å beholde ved å bruke det riktige verktøyet i din DAW;
- deretter legge til raske fade-in og fade-out på begynnelsen og slutten av hvert lydspor for å unngå at digitale klikk oppstår.
Til slutt vil du få et så rent vokalspor som mulig, som vil være lettere å mikse.
Trinn 3: Gain staging
Når sporet ditt er korrekt redigert, er det vanligvis et godt tidspunkt å justere nivået på setningene eller stavelsene.
Med andre ord, for å gjøre en slags gain staging.
Dette trinnet er super viktig fordi det virkelig vil gjøre forskjellen mellom en amatørmikser og en proffmikser.
I det minste når det gjelder miksing av lead vokaler.
La oss si at du har et sangspor med både myke og sterke partier:

Hvis du lar sporet være slik og prøver å komprimere det, vil du møte følgende problem:

- hvis du komprimerer med et høyt terskel, vil bare de sterke partiene bli påvirket;
- men hvis du senker terskelen for å ta hensyn til de svake partiene, vil de sterke partiene bli fullstendig knust av kompresjonen fordi de vil være godt over terskelen.
Derimot, ved å justere nivået på sporet setning for setning, vers for vers, til og med stavelse for stavelse, vil du unngå problemer når du legger til effekter og du kan sikre at hvert ord er forståelig i miksen.
Det er ikke alltid nødvendig å gå helt ned til stavelsen, men sørg for at setningene i gjennomsnitt er på riktig nivå.
For dette kan du enten bruke et enkelt gain-plugin med en automasjonskurve, eller bruke et automatisk gain-plugin som Vocal Rider fra Waves.
Det er verdt å merke seg at sistnevnte kan generere en automasjonskurve automatisk, som du kan redigere manuelt om nødvendig for å bli litt mer presis.
Trinn 4: Subtraktiv equalization
Som regel er det første du må gjøre når du mikser en lead-stemme, å rense den ved å bruke equalization.
Eller mer presist, korrigere frekvenser som ikke høres behagelige ut.
Typisk vil man ofte finne rumling i bassen, under 50-100 Hz, som mer tilsvarer bakgrunnslyder (elektriske, utendørs…) enn stemmen i seg selv.
Alt dette kan du enkelt fjerne eller dempe med høypassfiltre (eller low-shelf).
Deretter må du korrigere de andre frekvensproblemene du hører.
Denne kan være knyttet til alle slags årsaker som er mer eller mindre håndterbare, som:
- akustikken i rommet hvor du spiller inn (uten akustisk behandling kan du for eksempel oppleve effekten av modale resonanser);
- frekvenser som er litt harde for øret knyttet til mikrofonkonstruksjonen og/eller kvaliteten på forforsterkeren;
- frekvenser fra stemmen som er mer fremtredende med én mikrofon enn med en annen (dette avhenger av sangeren/sangeren);
- kvaliteten på prestasjonen til sangeren/sangeren.

For å korrigere disse problemene er det enklest å bruke den vanlige klassiske equalizationsteknikken:
- Identifiser problemet eller elementet du ønsker å korrigere
- Legg til en EQ-filter med klokkeform med
- en relativt høy Q-faktor (4 til 10)
- en høy forsterkning (+10 dB for eksempel)
- Gå sakte gjennom frekvensspekteret med dette filteret til du hører problemet komme tydelig frem (i form av resonans, for eksempel)
- Demp signalet (i stedet for +10dB) på frekvensbåndet du befinner deg i ved å justere Q-faktoren om nødvendig
Jeg insisterer spesielt på det første punktet: ta deg tid til å lytte til sporet ditt først for å identifisere elementene som plager deg. Faktisk, selv om miksing av stemmer er noe presist, er det unødvendig å korrigere små problemer som ikke høres ut i det hele tatt, men som ville blitt fremhevet på grunn av filteret på +10 dB…
Når dette trinnet er fullført, kan EQ-en din kanskje se slik ut (men kanskje noe helt annet, siden det alltid avhenger av kildesignalet):

Merk forresten at vi snakker om en equalization for en lead-stemme. Hvis du for eksempel mikser kor, vil equalization sannsynligvis være veldig forskjellig.
Trinn 5: De-Esser
Noen bokstaver eller stavelser har en tendens til å komme aggressivt frem i de høye tonene når de er spilt inn av en mikrofon.
Typisk er det lyder som konsonanten “S”, men også “F”, “T” eller “CH”.
Dette er et lydfenomen som generelt kalles sibilance og som kan vises mer eller mindre sterkt avhengig av mikrofonen og formen på sangeren/sangerens munn.
At disse lydene kommer frem kan ha en rekke ubehagelige konsekvenser for miksen din: på den ene siden kan det bli raskt irriterende for lytteren, men det kan også skade reverb-effektene du vil legge til etterpå, som er veldig følsomme for disse lydene.
LyListen for eksempel effekten av “S” på teksturen av reverb i dette eksemplet:
Det er derfor viktig å kontrollere dette sibilance-fenomenet så mye som mulig.
Selv om det finnes tips for innspilling av stemmer som kan minimere dette, vil du ofte måtte håndtere problemet i miksingen.
Dessverre er det umulig å bruke en enkel equalizer for å kutte signalet i 4 eller 5 kHz: hvis du kutter kontinuerlig, vil det påvirke hele sporet, og stemmen vil høres merkelig ut.
Løsningen er derfor å bruke det som kalles en de-esser som Fabfilter Pro-G (eller en av disse gratisalternativene):
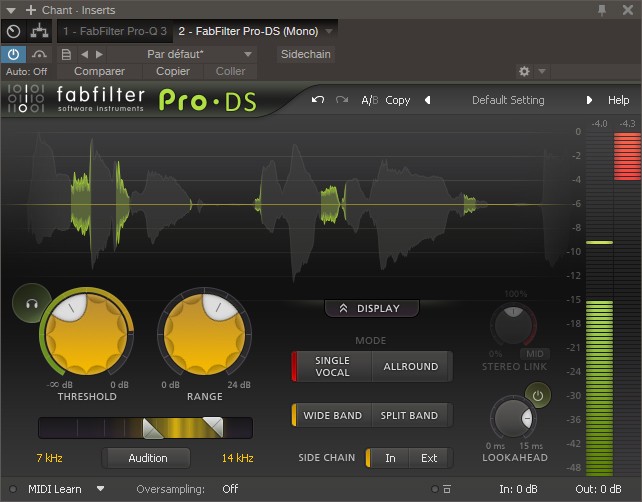
Ved hjelp av en multibånds algoritme, vil denne effekten tillate deg å kontrollere sibilansen ved å dempe kun visse frekvenser når lyder som “S” blir oppdaget.
Dermed uten å påvirke frekvensene som ikke er berørt av problemet.
Vær imidlertid forsiktig med å justere pluginen for ekstremt, da dette kan degradere signalet: noen desibel med gain-reduksjon (GR) bør være tilstrekkelig i de fleste tilfeller.
Trinn 6: Komprimering, uunngåelig for miksing av stemmer
Nå som signalet er renset, kan du gå videre til komprimering av stemmesporet.
Noen ganger vil du ikke trenge komprimering. Kanskje fordi musikksjangeren ikke tillater det, eller fordi det allerede har vært en analog komprimering under innspillingen.
Det sagt, 99% av tiden viser innspillinger av stemmer eller sang seg å være ganske dynamiske: noen setninger, noen stavelser vil komme frem mens andre vil være mindre fremtredende.
Konsekvensen: umulig å få frem alle ordene på en forståelig måte i miksingen. Med andre ord, hvis du prøver å justere volumfaderen for stemmesporet ditt, vil du ikke klare å finne en innstilling som passer: til tider vil sporet være for høyt og du vil ha lyst til å senke faderen, og til andre tider vil teksten bli druknet i miksen og du vil ha lyst til å heve faderen.
Dette er et tegn på at sporet ditt trenger komprimering for å redusere det dynamiske området.
Legg derfor til kompressoren du velger på sporet (for å begynne med, den som er inkludert som standard i din DAW kan være et godt utgangspunkt) og juster den for å jevne ut sporet ditt:

Mengden komprimering du vil bruke, som tilsvarer gain-reduksjon (Gain Reduction eller GR), vil avhenge av musikksjangeren: på akustisk musikk eller jazz, vil du sannsynligvis sikte på en minimal effekt, mens på rap eller heavy metal vil du trenge en mye mer fremtredende stemme, mye mer “inn i ansiktet”.
Det sagt, målet er likevel at kompresjonseffekten skal være så lite hørbar som mulig, siden komprimering kan generere audioartefakter (typisk en pumpingeffekt).
Hvis en enkelt kompressor ikke er tilstrekkelig for å homogenisere nivået på stemmesporet, ikke nøl med å bruke to på rad for å håndtere forskjellige aspekter av sporet (besøk min guide til komprimering av stemmer for mer forklaring).
Trinn 7: Additiv equalizing
Etter komprimering, er det vanligvis et godt tidspunkt å legge til en EQ som vil jobbe additivt, det vil si med positive gain-innstillinger.
Ideen er at nå som du har fjernet problemene fra signalet ved hjelp av subtraktiv equalizing (eller den eventuelle de-esseren) og at dynamikken er korrekt kontrollert av komprimeringen, vil du finjustere frekvensresponsen ved å forsterke det du ønsker eller trenger å høre mer av.
Med andre ord, du vil forbedre miksen av stemmesporet ditt ved å forme lyden din.
Det er opp til deg å se hvilke frekvenser som skal forsterkes og hvor mye gain som skal brukes, men for eksempel er det vanlig å forsterke litt bass for å gi mer kropp til stemmen eller heve diskanten for å gi mer luft og hjelpe stemmen å trenge gjennom miksen.
Her er et eksempel på et stykke der diskanten er presset til det ytterste (ikke veldig behagelig, men greit…):
Dette bringer meg til et viktig punkt: visst, jeg liker ikke å gi altfor presise regler, men hvis du merker at din equalizing overstiger +5 eller +6 dB, spør deg selv “gir det jeg gjør mening?”.
Så mye som det kan være lett å forstå på et trommesett, kan å forvrenge en vokalspor skje veldig raskt — derfor er det nødvendig å være forsiktig.
Eksempel: i stedet for å booste diskanten til +15 dB, kanskje er mixen generelt for høy i diskanten? I så fall, reduser heller diskanten på andre spor i stedet for å forvrenge vokalsporet… 😉
Trinn 8: Saturasjon (valgfritt)
Dette er helt valgfritt, men det kan noen ganger være interessant å legge til harmonisk saturasjon.
Det kan være saturasjon drevet til maks for å generere en spesialeffekt som distorsjon, men som standard anbefaler jeg heller å holde meg til mer subtile saturasjonsinnstillinger.
Ideen er å forsterke den harmoniske innholdet av signalet for å gjøre lyden litt varmere, litt mer interessant, litt mer bemerkelsesverdig i mixen.
Merk forresten at denne teknikken ikke er spesifikk for miksing av vokaler: den kan brukes på alle slags instrumenter.

Selvfølgelig, hvis opptaket allerede er gjort med en farget forforsterker (som Neve for eksempel), kan det å legge til saturasjon igjen risikere å ikke tilføre mye — eller til og med skade kvaliteten på mixen.
På den annen side, hvis forforsterkeren som brukes er nøytral (noe som er tilfelle med de fleste forforsterkere integrert i lydkort) eller har en tendens til å gi en ganske flat gjengivelse, så er det sannsynligvis verdt å legge til litt kosmetisk saturasjon, takket være plugins som simulerer båndmagnetiske effekter for eksempel.
Noen anbefalinger av plugins:
- Kazrog True Iron ;
- Waves J37 (-10% med denne linken og koden som vises) ;
- Soundtoys Radiator ;
- eller for eksempel en av disse gratis saturasjonsplugins.
Trinn 9: Parallell kompresjon (valgfritt)
Selvfølgelig kan alle slags behandlinger brukes på vokaler.
Målet med denne artikkelen er derfor ikke å liste opp de mange eksisterende mulighetene — ellers ville du rett og slett vært tapt midt i all denne informasjonen (siden det allerede er mye på denne siden 🙂 ).
Imidlertid er en teknikk som både er veldig praktisk og vanlig brukt, den som kalles “parallell kompresjon” eller “New York Compression”.
Denne metoden går ut på å komprimere sterkt et spor identisk med vokalsporet og deretter mikse det subtilt med originalsignalet.
Dette gjør at man kan beholde toppene og en del av dynamikken i signalet, men samtidig støtte “fra bunnen” de svakere lydene, noe som gjør at vokalen lett skiller seg ut i mixen i forhold til de andre instrumentene.
For mer informasjon, inviterer jeg deg til å se min veiledning om parallell kompresjon.
Trinn 10: Reverb og Delay
Til slutt består det siste trinnet ofte i å plassere lead-vokalen i et stereorom, i tre dimensjoner.
<p.Det vil si, legge til reverb på vokalsporet ditt.
Som standard anbefaler jeg heller å gjøre dette til slutt for å unngå at effekten maskerer visse feil eller problemer med mixen din.
Til slutt, jeg sier reverb, men det er også mulig å bruke andre effekter som for eksempel delays.
Enkelt sagt, det avhenger av musikksjangeren og tettheten av effekten du leter etter.
Reverb
For å gjøre stemmen mindre tørr, er det ofte den enkleste løsningen å legge til en reverb-plugin.
Faktisk gjør denne effekten at en stemme umiddelbart blir mer interessant ved å gi den en stereodimensjon.
Ulempen er at <strong jo mer reverb du legger på en stemme, jo mer vil den høres fjern ut:
Varigheten av reverben og dens relative volum i forhold til stemmesporene vil derfor være to kritiske parametere du absolutt må mestre:
- en for lang reverb vil drukne det grunnleggende signalet, og teksten vil bli mindre forståelig;
- en for sterk reverb vil gi en følelse av avstand fra lydkilden.
Derfor, for enkelte moderne musikksjangre som krever en veldig frontal stemme i miksen, må du kanskje gå glipp av reverben.
Deretter vil typen reverb også påvirke dens effektivitet i miksen.
Personlig har jeg en liten preferanse for plate-reverber (spesielt Abbey Road Reverb Plates fra Waves: -10% med denne lenken og koden som vises) samt for noen algoritmiske reverber (som de fra ValhallaDSP).
Men du er selvfølgelig fri til å eksperimentere med alle plugin-utgivelser.
Delay
Når en reverb ikke passer for å gi dimensjon til et stemmespor, kan det være interessant å bruke en delay-effekt (eller ekko på fransk, det er det samme).
Dette kan virke overraskende, fordi delay ofte oppfattes som en spesialeffekt, men det er faktisk en effekt som ofte brukes under miksing av stemmer.
Mer spesifikt bruker mange ingeniører en teknikk som kalles slapback delay — veldig enkel, men ekstremt effektiv for å gi dybde til en stemme.

Konkret består dette av å bruke en delay-plugin innstilt på følgende måte:
- en ekstremt kort ekkotid (50-100 ms i gjennomsnitt);
- en enkelt repetisjon (så en feedback-innstilling på 0%);
- kun mono (repetisjonen av signalet i venstre kanal er identisk med den i høyre kanal).
Selvfølgelig er det nødvendig å justere ekkoeffekten for å unngå at den tar overhånd i forhold til grunnsporene.
Besøk denne artikkelen for litt mer info om emnet.
Gratulerer, du vet nå hvordan du mikser en stemme!
Først og fremst, gratulerer med å ha kommet til slutten av denne lange artikkelen! 🙂
Du kjenner nå trinnene for å lykkes med miksing av en lead-stemme, uansett musikkstil eller innspilling (selv om kvaliteten på miksen din selvfølgelig vil avhenge av kvaliteten på opptaket).
Nå er det siste trinnet ganske enkelt å sette det ut i praksis: ta en gammel miks, fjern alle effektene fra stemmesporene og begynn å mikse den på nytt ved å følge trinnene i denne artikkelen.
Så gjør det samme med neste låt.
Raskt vil du merke at sangsporene dine blir mer slående og tar mer plass i miksen.
Med det, sees vi snart for flere artikler om lydmiksing 🙂